Кто будет принимать решения вместо нас: человек, алгоритм или система?
Представьте, что вам отказали в кредите.
Вы спрашиваете: почему?
В ответ получаете: «Решение принято системой».
Звучит современно.
Почти научно.
И очень удобно для того, кто должен был бы объяснить решение.
Только система сама по себе ничего не решила.
Кто-то выбрал данные.
Кто-то определил, что считать риском.
Кто-то установил порог.
Кто-то решил, что один показатель важнее другого.
Кто-то купил модель, внедрил её и доверил ей часть процесса.
Поэтому фраза «так решил алгоритм» для меня примерно такая же содержательная, как «так получилось».
Самая опасная фраза про алгоритм — «так посчитала система».
1. Алгоритмы уже не только советуют, что посмотреть вечером
Когда говорят об искусственном интеллекте, люди часто представляют чат-бота, который пишет письмо, или генератор картинок.
Но алгоритмическое принятие решений гораздо старше нынешнего AI-бума.
Банки оценивают кредитный риск.
Страховые компании рассчитывают тарифы.
Работодатели ранжируют резюме.
Платформы определяют, кому показать объявление.
Государственные системы могут приоритизировать заявки, выявлять риск мошенничества или помогать распределять ресурсы.
Разница только в степени автоматизации.
Есть три принципиально разные ситуации.
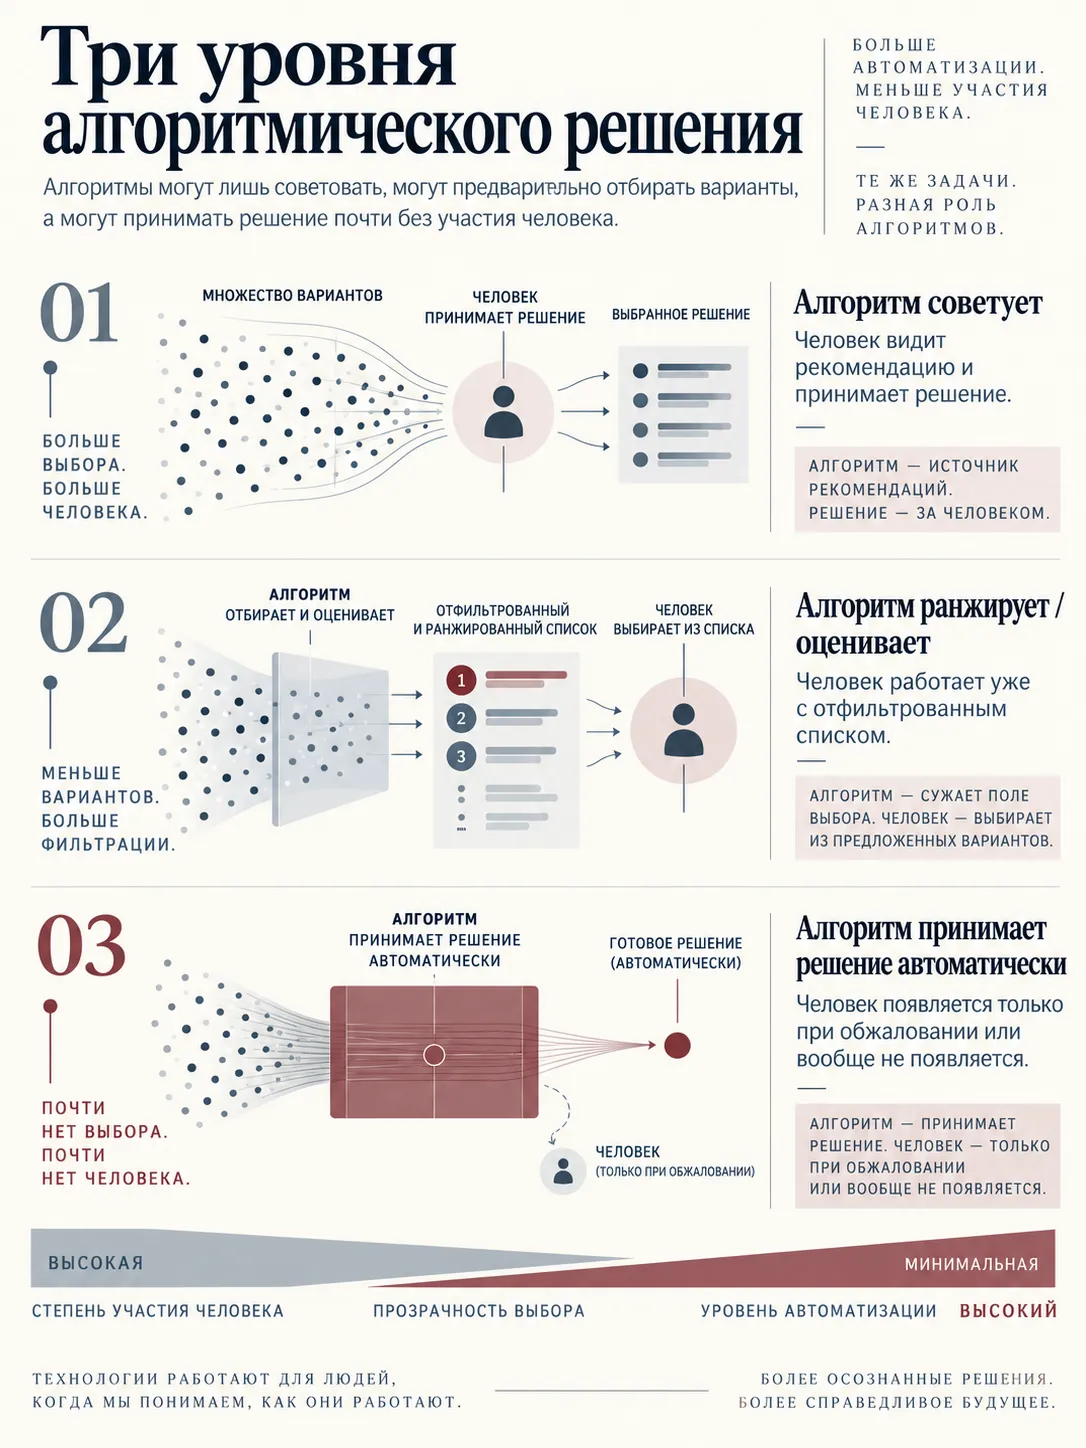
Эти уровни часто смешивают, когда говорят «решение принимает человек».
Если система отсеяла 90% кандидатов ещё до того, как рекрутер открыл список, человек формально участвует.
Но пространство его выбора уже создано алгоритмом.
2. Алгоритм может быть справедливее человека. Иногда
Важно не делать из алгоритмов злодеев.
Человек тоже не является эталоном объективности.
Мы устаём.
У нас есть стереотипы.
Мы симпатизируем людям, похожим на нас.
Принимаем разное решение утром и вечером.
Можем оценить одинаковую ситуацию по-разному просто из-за настроения.
Хорошо спроектированная система способна применять одинаковые правила к тысячам заявок и обнаруживать закономерности, которые человеку сложно увидеть.
Это реальное преимущество.
Проблема начинается, когда «одинаковое правило» путают со «справедливым правилом».
Можно одинаково применять плохой критерий.
И делать это с прекрасной скоростью.
Последовательность ≠ справедливость.
Алгоритм может одинаково применять правило ко всем и при этом систематически давать худший результат определённым группам, если само правило или данные создают перекос.
3. Данные помнят прошлое
Допустим, компания хочет автоматизировать подбор людей на руководящие позиции.
Она обучает модель на данных о сотрудниках, которые успешно становились руководителями последние двадцать лет.
Звучит логично.
Но если исторически руководителями чаще становились люди определённого пола, возраста, образования или социального происхождения, модель может выучить не «что делает человека хорошим руководителем», а «на кого раньше был похож хороший руководитель в нашей компании».
Это не одно и то же.
OECD в отчёте о применении AI в государственном управлении отдельно предупреждает: исторические кадровые данные основаны на прошлых решениях людей и могут закреплять эти прошлые модели поведения в алгоритмах.
Похожие риски возникают, когда система использует косвенные признаки.
Она может не видеть в анкете графу «доход семьи в детстве».
Но видеть район проживания, школу, образование, историю занятости и десятки других переменных, которые частично с этим связаны.
Дискриминация не обязана быть записана в коде строкой «не давать кредит такой-то группе».
Иногда достаточно хорошего прокси.
4. «Но у нас в конце всё проверяет человек» — не волшебное решение
Есть популярная формула: human in the loop.
То есть окончательное решение принимает человек.
Прекрасно.
Только человек должен действительно принимать решение, а не ставить галочку под тем, что уже посчитала машина.
У этого есть название — automation bias, или склонность чрезмерно доверять автоматизированной рекомендации.
Если система выглядит сложной, дорогой и «обученной на миллионах данных», человеку психологически непросто сказать: «Нет, я думаю, она ошиблась».
Особенно если у сотрудника за день двести заявок и семь минут на каждую.
OECD отдельно обращает внимание на этот риск: люди могут не перепроверять автоматизированные рекомендации даже тогда, когда формально несут ответственность за окончательное решение.
Automation bias — склонность человека чрезмерно доверять рекомендации автоматизированной системы и реже её оспаривать, даже если ответственность за решение остаётся на человеке.
Именно поэтому «у нас есть человек в процессе» — хороший старт, но ещё не гарантия контроля.
Нужно знать, может ли этот человек реально отменить решение, понимает ли он логику модели, получает ли достаточно информации и не наказывают ли его за слишком частые «ручные» исключения.
5. Чёрный ящик — это не ответ человеку
Особенно интересно это становится там, где решение влияет на права и возможности.
В США Consumer Financial Protection Bureau специально разъясняло банкам: если кредитное решение принимается с использованием сложного или даже «чёрного ящика», это не отменяет обязанность назвать человеку конкретные и точные причины отказа, когда такая обязанность установлена законом.
Мне кажется, это очень важный принцип, который гораздо шире кредитов.
Чем сильнее решение влияет на жизнь человека, тем страннее звучит ответ «мы сами не понимаем, почему модель так решила».
Если организация не способна объяснить собственный инструмент, возникает вопрос: почему она считает приемлемым использовать его для значимых решений?
Сложность технологии не должна превращаться в право организации не объяснять последствия её применения.
6. Кто в итоге отвечает?
Вот главный вопрос.
Разработчик модели?
Компания, которая её купила?
Сотрудник, который нажал кнопку?
Руководитель, утвердивший процедуру?
Поставщик данных?
На практике ответственность может распределяться между несколькими участниками. Именно поэтому такие рамки, как NIST AI Risk Management Framework, говорят не только о качестве самой модели, но и об управлении рисками на всём жизненном цикле AI-системы.
Нас должно интересовать не только «насколько хорошо AI предсказывает».
Но и:
для какой цели он используется?
Какие данные берет?
Какие ошибки считаются допустимыми?
Кто страдает от ошибки?
Можно ли обжаловать результат?
Кто заметит, если система начала работать хуже?
Кто имеет право её остановить?
1. Что именно автоматизировано: рекомендация, рейтинг или финальное решение?
2. Какие данные используются?
3. Есть ли чувствительные признаки или их прокси?
4. Можно ли получить понятное объяснение результата?
5. Есть ли реальный человеческий контроль?
6. Можно ли оспорить решение и кому?
7. Кто несёт ответственность за ошибку?
7. Главный выбор — не «человек или машина»
Мне кажется, именно здесь общественная дискуссия часто идёт не туда.
Мы спрашиваем: кто лучше принимает решения — человек или AI?
А нужно спрашивать: как спроектировать систему, в которой сильные стороны технологии используются, а слабые можно обнаружить и исправить?
Потому что человек ошибается.
Алгоритм тоже ошибается.
Только человек обычно способен испортить судьбу одному кандидату за раз.
Автоматизированная система может масштабировать ошибку на сто тысяч человек до обеда.
Зато она же может масштабировать хорошую процедуру, единые критерии и более быструю обработку.
Разница — в архитектуре контроля.
П.С. Если вам когда-нибудь скажут «это невозможно изменить, потому что так решила система», я бы начала именно с этого места. Системы, знаете ли, тоже кто-то проектирует.